

La carrera por la voz sintética «perfecta» —la que suena tan natural que se olvida que es una máquina la que habla— lleva años acelerándose, pero en los últimos meses se ha vuelto especialmente reñida entre un puñado de empresas especializadas en audio: ElevenLabs, Cartesia, Fish Audio y algún gigante tecnológico que también quiere su parte del pastel. En agosto de 2026, Cartesia lanzó la última versión de su modelo insignia y se colocó, según los rankings independientes, en el primer puesto de las dos tablas de clasificación de voz más seguidas del sector.
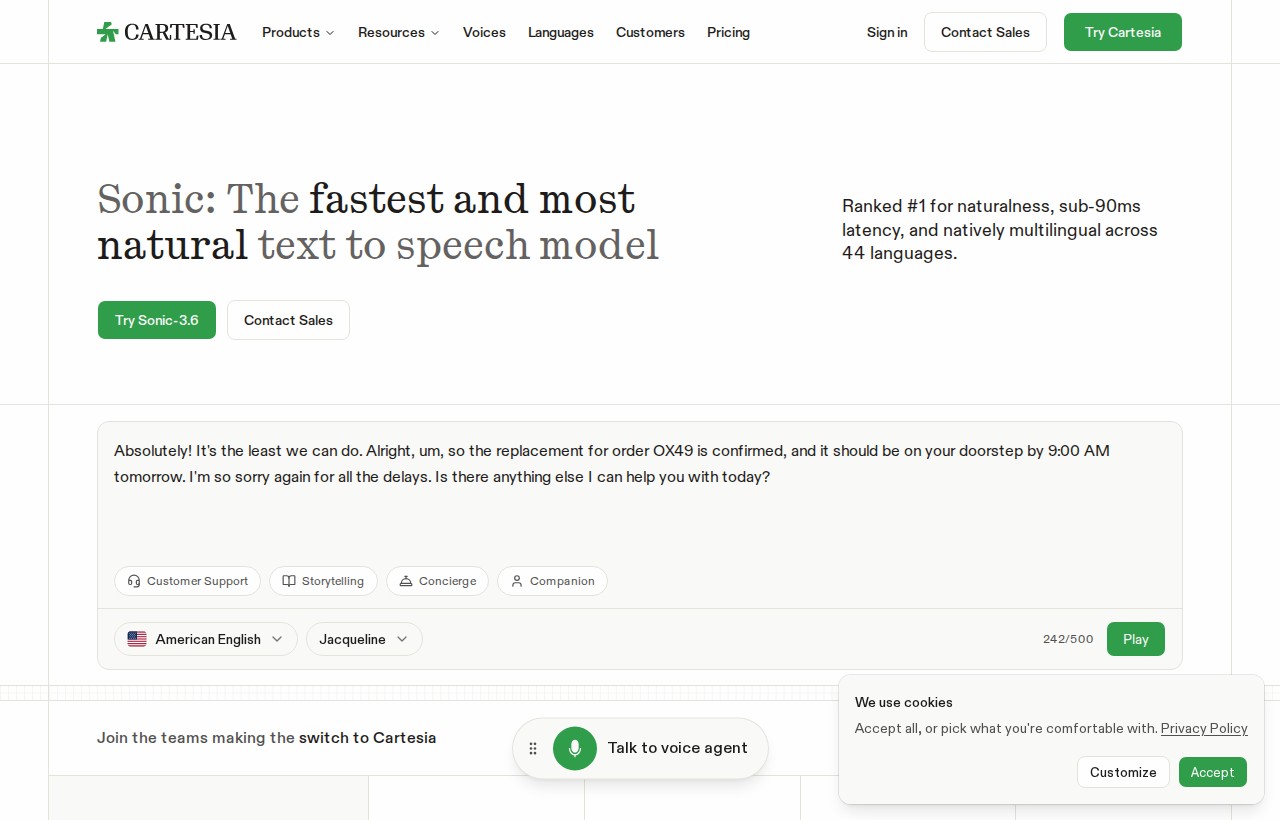
Sonic-3.6 es el modelo de texto a voz (TTS) en tiempo real de Cartesia, una compañía fundada por investigadores especializados en arquitecturas de modelos de espacio de estados (los llamados «state space models», la misma familia de investigación de la que salió Mamba). Sonic-3.6 llega apenas tres meses después de Sonic-3.5 y presume de ser, según su propio fabricante, el modelo de voz más rápido y natural disponible hoy en el mercado.
🔍 ¿Qué es Sonic-3.6 y qué problema resuelve?
Cartesia es una startup de inteligencia artificial especializada en modelos de voz en tiempo real, fundada en 2023. A diferencia de otros proveedores de TTS que priorizan la calidad de audio en generación por lotes (offline), Cartesia ha construido su tecnología sobre arquitecturas de espacio de estados en lugar de transformers, lo que le permite ofrecer una latencia extremadamente baja: menos de 90 milisegundos hasta el primer fragmento de audio (time-to-first-audio).
El problema que resuelve Sonic-3.6 es el que enfrenta cualquier aplicación que necesita voz sintética para una conversación en vivo —un agente de atención al cliente, un asistente de voz, un compañero de aprendizaje de idiomas— y no puede permitirse ni un segundo de retraso entre lo que el sistema «decide decir» y el momento en que el usuario lo escucha. Los modelos de TTS tradicionales, pensados para generar audiolibros o locuciones offline, no están optimizados para ese caso de uso; Sonic-3.6 sí.
Además de la velocidad, el modelo ha subido notablemente el listón en naturalidad: sigue el guión con fidelidad (pronuncia correctamente códigos de confirmación y heterónimos sin necesidad de preprocesado), varía el ritmo y la entonación según el contexto emocional sin necesidad de etiquetas SSML, y reproduce de forma natural las muletillas («eh», «mmm») como pausas de «pensamiento» realistas.
⚙️ Características principales
- Latencia sub-90ms: gracias a su arquitectura basada en modelos de espacio de estados, Sonic-3.6 empieza a producir audio en menos de 90 milisegundos, un factor crítico para agentes de voz conversacionales en tiempo real.
- 44 idiomas y 61 locales: cobertura muy amplia que incluye incorporaciones recientes como el odia y el urdu, además de soporte específico para hinglish (mezcla de hindi e inglés).
- Clonación instantánea de voz: permite clonar una voz a partir de apenas 10 segundos de audio de referencia, junto con diccionarios de pronunciación personalizados (incluyendo overrides en IPA para palabras específicas).
- Etiquetas de expresión inline: se pueden insertar expresiones no verbales como [laughter] directamente en el texto de entrada, además de controlar velocidad, volumen y emoción vía parámetros de la API.
- Streaming multiprotocolo: soporta WebSocket, transmisión por bytes y Server-Sent Events (SSE), lo que facilita su integración en distintos tipos de aplicaciones en tiempo real, incluyendo el plugin oficial para LiveKit Agents.
- Liderazgo en benchmarks independientes: según Artificial Analysis, Sonic-3.6 ocupa el primer puesto tanto en el ranking de «Provider Voice» (1.283 Elo) como en el más exigente «Controlled Voice» (1.123 Elo), que clona todos los modelos evaluados sobre las mismas ocho voces de referencia para aislar la calidad del motor de síntesis de la calidad del catálogo de voces.
Este enfoque en la latencia ultra baja lo diferencia de modelos generalistas de audio como Seed Audio 1.0 de ByteDance, que cubre voz, música y efectos en un mismo modelo pero sin el mismo nivel de especialización en conversación en tiempo real. Según Wikipedia, un conversor texto-voz es la generación por medios automáticos de una voz artificial que reproduce el sonido que produciría una persona leyendo el mismo texto en voz alta, y la evolución de esta tecnología en la última década ha pasado de voces robóticas fácilmente identificables a modelos neuronales prácticamente indistinguibles del habla humana real, como demuestra el propio Sonic-3.6 en los benchmarks mencionados.
💰 Precio y planes
Cartesia ofrece varios niveles de suscripción, según su página oficial de precios:
- Free: unos 27 minutos de audio TTS al mes, pensado para pruebas iniciales.
- Pro (5 $/mes): unos 133 minutos de audio, con derechos de uso comercial y clonación de voz instantánea para cargas de trabajo pequeñas.
- Startup (49 $/mes): unos 1.667 minutos de audio, pensado para equipos con mayor volumen, incluyendo organizaciones y clonación de voz profesional.
- Scale (299 $/mes): unos 10.667 minutos de audio, para aplicaciones más grandes que necesitan más concurrencia y soporte prioritario.
- Enterprise: condiciones a medida en uso, concurrencia, cumplimiento normativo y despliegue.
A nivel de coste por carácter, Cartesia factura 1 crédito por carácter en síntesis estándar y 1,5 créditos por carácter en clonación de voz Pro (tras una tarifa única de entrenamiento). Analistas independientes sitúan a Sonic-3.6 en torno a 49 $ por millón de caracteres, la mitad que ElevenLabs Eleven v3 (100 $ por millón de caracteres), aunque por encima de opciones más económicas como Speechify Simba 3.2. Como siempre, conviene revisar la página oficial de precios de Cartesia para confirmar las cifras vigentes en el momento de contratar.
✅ Análisis: Pros y Contras
| ✅ Ventajas | ❌ Desventajas |
|---|---|
| Latencia sub-90ms que lo convierte en una de las mejores opciones del mercado para agentes de voz conversacionales en tiempo real. | Es un modelo cerrado, sin pesos abiertos ni repositorio en Hugging Face, por lo que no hay opción de autoalojamiento. |
| Primer puesto en los dos rankings de voz de Artificial Analysis, con datos de evaluación independientes y no solo del propio fabricante. | El precio por millón de caracteres, aunque competitivo frente a ElevenLabs, sigue siendo más alto que alternativas económicas como Speechify. |
| Cobertura de 44 idiomas y 61 locales, con incorporaciones recientes poco habituales en otros proveedores, como el odia o el hinglish. | El plan gratuito es limitado (unos 27 minutos al mes), insuficiente para probar a fondo un caso de uso de producción. |
| Clonación de voz instantánea a partir de solo 10 segundos de audio, útil para personalización rápida sin procesos largos de entrenamiento. | Al estar disponible solo como API alojada en fase beta, algunas integraciones avanzadas todavía pueden cambiar entre versiones. |
| Etiquetas de expresión inline y control de emoción sin SSML simplifican mucho la generación de voz expresiva desde el propio texto. | Comparado con Pika Speech, su coste por minuto es más elevado, según los análisis de mercado citados por Pika. |
⭐ Puntuación oledir.com: 5/5
Puntuación: 5/5 — Sonic-3.6 combina liderazgo verificado en benchmarks independientes, una latencia que lo hace apto para conversación en tiempo real y una cobertura de idiomas muy superior a la media del sector, lo que lo convierte en una referencia clara dentro de la categoría de texto a voz en 2026.
- 🎯 Facilidad de uso: 4/5
- 💡 Funcionalidades: 5/5
- 💰 Relación calidad-precio: 4/5
- 🔧 Integraciones: 5/5
- 📞 Soporte: 4/5
🚀 ¿Para quién es ideal Sonic-3.6?
Sonic-3.6 está diseñado sobre todo para equipos que construyen agentes de voz conversacionales: asistentes de atención al cliente, agentes de ventas por voz, aplicaciones de aprendizaje de idiomas que necesitan corregir la pronunciación en tiempo real o productos de compañía IA donde la naturalidad y la velocidad de respuesta son decisivas para la experiencia de usuario. La integración con LiveKit Agents lo hace especialmente atractivo para quien ya construye infraestructura de voz en tiempo real sobre esa plataforma.
También encaja bien en empresas con necesidades de localización multilingüe, gracias a su cobertura de 44 idiomas, algo poco habitual incluso entre los líderes del sector. Por el contrario, para proyectos que solo necesitan generar locuciones offline (audiolibros, doblaje de vídeos pregrabados) sin restricciones de latencia, puede no justificarse el coste frente a alternativas más económicas orientadas a generación por lotes, como Pika Speech.
🔗 Prueba Sonic-3.6 gratis
👉 Visita Sonic-3.6 — Sitio oficial