Los agentes de IA que ejecutan tareas largas —sesiones de programación completas, investigación con cientos de fuentes contradictorias o verificación de diseños con miles de restricciones— necesitan un tipo de razonamiento distinto al de un chatbot que responde una pregunta puntual. Nemotron 3 Ultra es la respuesta de NVIDIA a ese problema: un modelo de 550.000 millones de parámetros publicado con pesos, datos de entrenamiento y recetas de forma abierta.
Se trata de uno de los modelos de razonamiento abierto más ambiciosos publicados hasta la fecha, en un momento en el que la competencia entre modelos abiertos y cerrados se libra cada vez más en el terreno de la eficiencia por token, no solo en la puntuación bruta de los benchmarks.
🔍 ¿Qué es Nemotron 3 Ultra y qué problema resuelve?
Nemotron 3 Ultra resuelve el problema de orquestar flujos de trabajo de agentes complejos y de larga duración combinando razonamiento de frontera con un alto rendimiento (throughput) y capacidad de adaptación a dominios específicos. Su arquitectura híbrida Mamba-Transformer de mezcla de expertos (MoE) activa solo 55.000 millones de los 550.000 millones de parámetros totales en cada inferencia, lo que reduce drásticamente el coste computacional sin sacrificar capacidad de razonamiento.
Publicado bajo la licencia permisiva OpenMDW-1.1 de la Linux Foundation, el modelo se distribuye junto a los pesos preentrenados, post-entrenados y cuantizados, además de los propios conjuntos de datos usados en su entrenamiento.
⚙️ Características principales
- Arquitectura MoE híbrida Mamba-Transformer: 55B parámetros activos de un total de 550B, con Latent MoE que invoca 4 expertos al coste de inferencia de 1.
- Multi-Token Prediction (MTP): reduce el tiempo de generación en secuencias largas.
- Ventana de contexto de hasta 1M de tokens: con rendimiento superior en el benchmark RULER a esa longitud de contexto.
- 5 veces más throughput que otros modelos abiertos de su clase, reduciendo el coste de tareas agénticas hasta un 30%.
- Publicación totalmente abierta: pesos, datos de entrenamiento y recetas disponibles, entrenado con SFT, RL y destilación multi-profesor (MOPD).
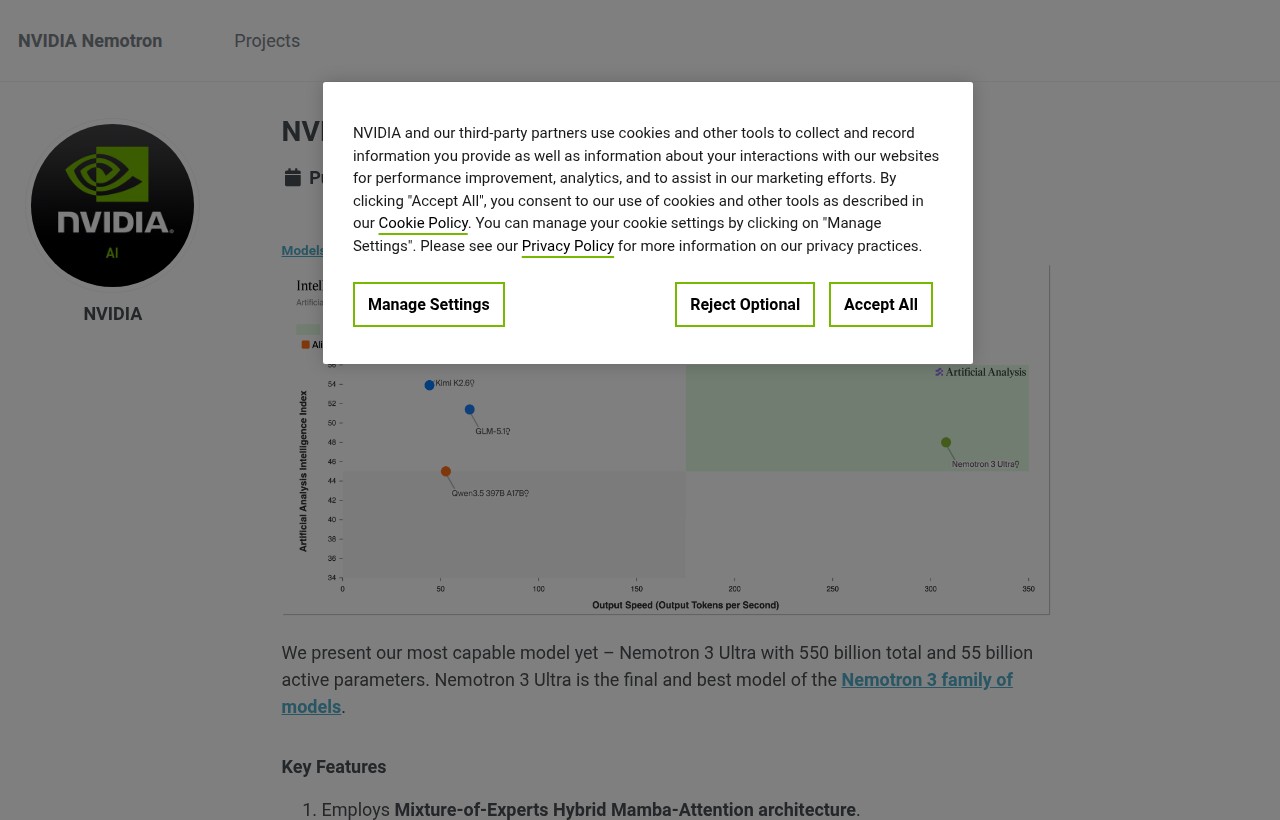
- Líder en el Intelligence Index de Artificial Analysis entre los modelos abiertos estadounidenses, por delante de Gemma 4 31B y gpt-oss-120b.
Para quienes buscan comparar este enfoque de razonamiento abierto con propuestas cerradas de última generación, Claude Fable 5 — El Nuevo Modelo Mythos de Anthropic ofrece una perspectiva complementaria dentro del mismo segmento de modelos de razonamiento avanzado.
Según Wikipedia, las arquitecturas de mezcla de expertos permiten escalar el número de parámetros sin disparar el coste de inferencia — el principio central sobre el que se apoya Nemotron 3 Ultra para lograr su rendimiento por token.
💰 Precio y planes
- Modelo de pesos abiertos: descarga gratuita de los checkpoints preentrenados, post-entrenados y cuantizados bajo licencia OpenMDW-1.1.
- Acceso vía API de terceros (Together AI, FriendliAI): facturación por token según el proveedor de inferencia elegido.
- Autoalojamiento: requiere infraestructura de GPU propia proporcional a los 55B parámetros activos por inferencia.
Esta estructura de precios fragmentada —sin una tarifa fija centralizada, a diferencia de los modelos cerrados con planes por suscripción— es habitual en los lanzamientos de pesos abiertos de gran tamaño. El coste real que acabe pagando cada equipo depende tanto del proveedor de inferencia elegido como del volumen de tokens procesado, por lo que conviene comparar varias opciones (o simular la carga de trabajo prevista) antes de comprometerse con una infraestructura de despliegue concreta.
✅ Análisis: Pros y Contras
| ✅ Ventajas | ❌ Desventajas |
|---|---|
| Publicación totalmente abierta: pesos, datos y recetas de entrenamiento | Ejecutarlo localmente exige una infraestructura de GPU considerable pese a la activación parcial de expertos |
| 5x más throughput que modelos abiertos comparables, reduciendo el coste de tareas agénticas hasta un 30% | El coste real depende del proveedor de inferencia elegido (no hay precio único centralizado) |
| Ventana de contexto de hasta 1M de tokens con buen rendimiento en RULER | La complejidad de la arquitectura híbrida MoE dificulta el ajuste fino para no especialistas |
| Líder en el Intelligence Index entre modelos abiertos estadounidenses | Menor ecosistema de herramientas maduras frente a modelos cerrados establecidos |
| Licencia permisiva OpenMDW-1.1 de la Linux Foundation | Pensado para casos de uso agénticos avanzados, no para un usuario final sin conocimientos técnicos |
⭐ Puntuación oledir.com: 4.5/5
Puntuación: 4.5/5 — Nemotron 3 Ultra representa un salto relevante en eficiencia de razonamiento abierto, especialmente para quienes construyen agentes de larga duración y necesitan throughput alto sin renunciar a la transparencia del modelo.
- 🎯 Facilidad de uso: 3/5
- 💡 Funcionalidades: 5/5
- 💰 Relación calidad-precio: 4.5/5
- 🔧 Integraciones: 4.5/5
- 📞 Soporte: 3.5/5
🚀 ¿Para quién es ideal Nemotron 3 Ultra?
Nemotron 3 Ultra está pensado para equipos de investigación y desarrolladores que construyen agentes de IA de larga duración —programación, investigación multi-fuente, verificación técnica— y que valoran la transparencia total del modelo (pesos y datos abiertos) junto a un alto rendimiento por token. También resulta especialmente relevante para empresas con políticas estrictas de soberanía de datos, que necesitan poder auditar o ejecutar el modelo dentro de su propia infraestructura en lugar de depender de una API cerrada de terceros.
No es la opción más adecuada si buscas un asistente listo para usar sin gestionar infraestructura propia, ni si tu prioridad es una API comercial cerrada con soporte directo del fabricante: para esos casos, un modelo propietario con servicio totalmente gestionado sigue siendo la vía más sencilla y con menor curva de entrada técnica.
🔗 Prueba Nemotron 3 Ultra gratis
👉 Visita Nemotron 3 Ultra — Sitio oficial